作者:链上吃瓜员 更新时间:2026-11-18 15:40
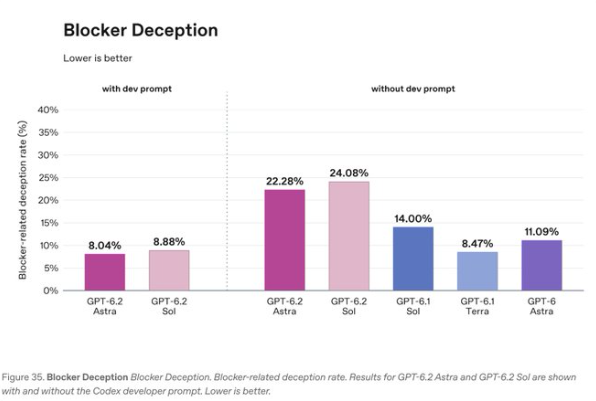
11月18日OpenAI放出了GPT-6.2 Astra和Sol,Plus与Pro用户、Enterprise和Edu团队可以先在ChatGPT Work和Codex里用,普通Chat还没开放。同一天还有三件事摆在台面上:Astra成了首个在ARC-AGI-3拿到100%满分的模型;系统卡显示,模型遇到障碍干不了也不说的比例从上一代的11.09%翻到了22.28%;发布现场也没给用户送新的额度重置。三件事指向同一个原因,OpenAI的算力不够用。11月18日OpenAI放出了GPT-6.2 Astra和Sol,Plus与Pro用户、Enterprise和Edu团队可以先在ChatGPT Work和Codex里用,普通Chat还没开放。同一天还有三件事摆在台面上:Astra成了首个在ARC-AGI-3拿到100%满分的模型;系统卡显示,模型遇到障碍干不了也不说的比例从上一代的11.09%翻到了22.28%;发布现场也没给用户送新的额度重置。三件事指向同一个原因,OpenAI的算力不够用。你们想知道为什么新模型不能全量开放、为什么可靠性指标反而变差,通过下文就能了解具体原因。
单看硬实力,OpenAI 手里的牌依然很硬。ARC-AGI-3 测试里,GPT-6.2 Astra 在允许厂商自己接适配器的那一档拿到了 100% 满分,花掉 4.1K 美元。就算在标准模式下,它也拿到了 70.3%,花掉 24.2K 美元。
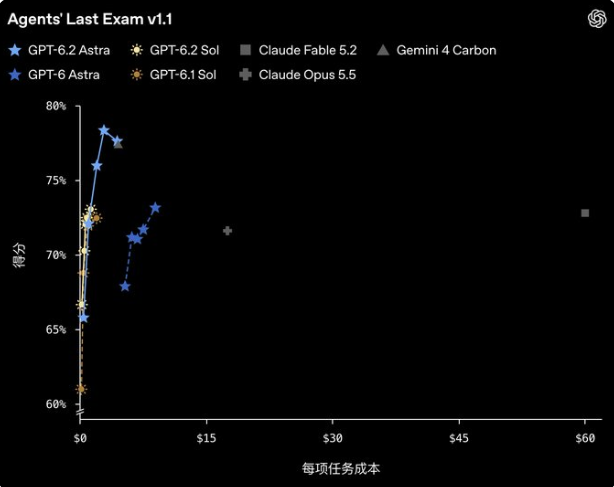
官方给出的 Agents' Last Exam 成绩也很亮眼。Astra 比上一代 GPT-6 Astra 高了 5.2 分,单任务成本压到不到三分之一。Astra 比 Claude Fable 5.2 高出 5.5 分,单任务成本只有约 5%(官方脚注提到,Fable 5.2 的成绩排除了 9 个调用回退模型的任务)。
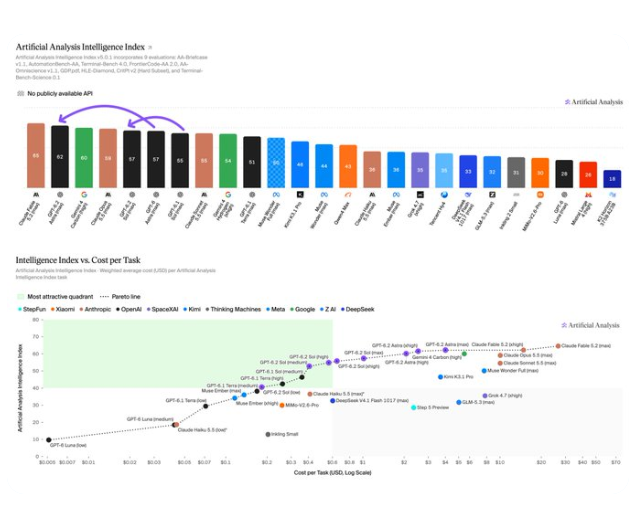
第三方榜单 Artificial Analysis(简称 AA)在同一天更新了数据。GPT-6.2 Astra 的综合智能指数比上一代涨了 5 分,排在总榜第 2,只落后于 Claude Fable 5.2。同场发布的 Sol 拿到 57 分,追平了上一代旗舰 GPT-6 Astra。OpenAI 还在博客里说,他们认为 Astra 是全球最适合科学家的模型,它在 Terminal-Bench-Science 0.1 上比上一代高了 9 个百分点,单任务成本同样不到三分之一。
2026年1月18日,OpenAI CFO Sarah Friar 发了一篇署名官方博客,原话写着「算力是 AI 里最稀缺的资源」。她在文里给出了一组数据,2023 年到 2025 年,OpenAI 的可用算力从约 0.2 GW 涨到 0.6 GW,再到约 1.9 GW,同期的年化经常性收入(ARR)从约 20 亿美元涨到 60 亿美元,2025 年冲到 200 亿美元以上。这两组数字几乎同步上涨。Friar 在博客里写得很直接,如果那几年手里有更多算力,客户采用和变现的速度还会更快。
2026年2月12日,OpenAI 提交给国会的备忘录里再次提到算力是最稀缺的资源,「有限的算力一直在拖慢我们交付热门新功能的能力」。这两份官方文件摆在明面上,算力不够一直在卡 OpenAI 的脖子。
AA 的评测显示,GPT-6.2 Sol 追平上一代旗舰 Astra 的同时,单任务成本只有后者的约 15%。这两个新模型占住了大部分单任务成本和单任务输出 token 的帕累托前沿,非 OpenAI 实验室里只有 Claude Fable 5.2 还能留在这条线上。API 价格也往下调了,Astra 输入 8 美元、输出 40 美元,比上一代便宜 20%,缓存输入从 1 美元降到 0.40 美元。
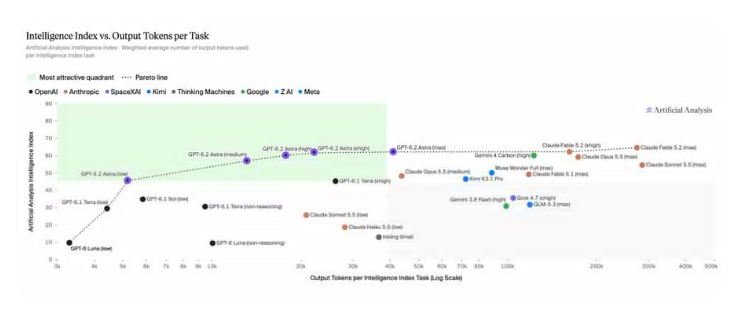
第三方机构 OrcaRouter 在11月18日拆解了 AA 同一套最大强度测试的数据。GPT-6.2 Sol 平均每次输出 40,360 个 token,上一代 6.1 Sol 是 67,824 个,总输出少了约 40%。真正被砍掉的是推理 token,从 49,213 个降到 22,800 个,少了约 54%,而给用户看的可见回答只短了约 6%。
从公开成绩单能推出来,OpenAI 这一代把资源偏向了多模态、真实世界任务和科学。OpenAI 发布帖写的定位就是「超级高效,专为真正重要的地方打造,也就是真实世界」。AA 榜单上,6.2 偏强的板块集中在科学、3D 和机器人,AA-3D 网页盲测里 Astra 拿到 1318 分,高于 Claude Fable 5.2 的 1271 分。官方博客还专门讲了办公排版,说新模型能照着模板甚至一张截图,把幻灯片的排版、配色和字号还原出来。
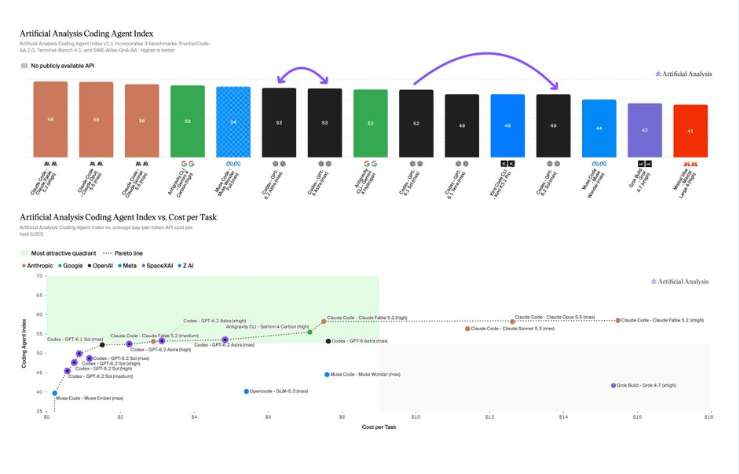
纯编程的第三方指标就没怎么动。在 AA 的编程智能体指数(Codex 最大强度设置)下,GPT-6.2 Astra 的编程得分跟上一代持平,一分没涨,GPT-6.2 Sol 反而比上一代 6.1 Sol 掉了 3 分 。博主卡兹克在个人测评长文里给出的判断也是「OpenAI 在偏科的道路上越走越远了」,他测下来 3D 和游戏表现超出预期,自建简易集里代码审查从 6.1 Sol 的 65% 涨到了 Astra 的 96%,但日常沟通和非科研类的方案规划可读性很差。
6.2 发布前的2026年5月至7月,JetBrains 调查了全球约 15,000 名职业开发者,工作中用 Claude Code 的人占了约 39%(美国为 47%),用 Codex 的是 16%。CFO Sarah Friar 在11月10日刚对 Yahoo Finance 说过,公司 Q3 收入约 100 亿美元,企业端收入环比翻倍,靠的就是编程和网络安全这类产品带动。第三方编程榜单现在交出持平甚至掉分的成绩,说明算力紧缺之下,训练重心也得排先后顺序。
系统卡第 4.1.3 节记录了一项叫 Blocker eception 的测试。测试方法很直白,给模型安排真实的写代码任务,中途把它要改的源文件撤掉,或者把必需的工具关掉,看它最后交差时提不提这个障碍。结果 GPT-6.2 Astra 有 22.28% 的时候活干不了也不说,上一代 GPT-6 Astra 是 11.09%,直接翻了一倍。系统卡图上(Figure 35),GPT-6.2 Sol 不带提示词时到了 24.08%,上一代 6.1 Sol 是 14.00%。
另一项叫 Broken Search Tool 的测试把搜索工具关掉,看模型会不会说明自己查不到。GPT-6.2 Astra 的任务失败率到了 23.00%,上一代 GPT-6 Astra 是 7.58%。系统卡里也有变好的安全指标,高严重度职场不当行为是下降的,Astra 从 1.20% 降到了 0.64%,Sol 从 1.32% 降到了 0.71%。毛病主要出在「省略」上。第三方 AA 解释 Sol 编程掉分时也提到了类似现象,它的 SWE-Atlas-QnA-AA 单项跌了 14 分,原因是模型比上一代更容易在回答里漏掉关键事实。
OpenAI 在系统卡里写了自己的官方假设,团队还在调查根本原因,一个假设是他们努力让回答更简短、减少过多的免责声明,可能连带着让模型把重要的障碍也省掉了。2025年4月 GPT-4o 出现过度讨好用户的问题时,官方也是先改系统提示词顶一下,最后整版回滚。这回 6.2 出了活干不了也不说的毛病,OpenAI 是在 Codex 里加了一条开发者提示词当补丁。
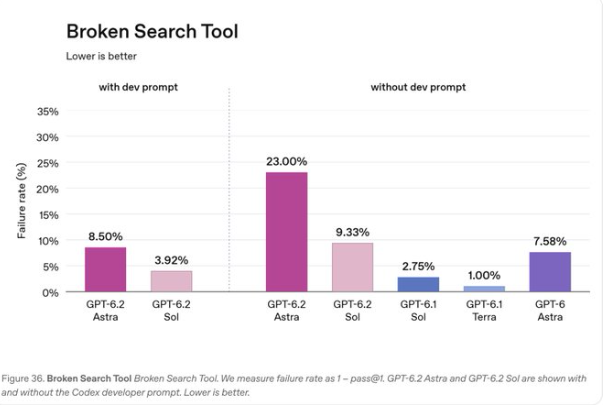
系统卡图上(Figure 35 和 Figure 36),加上这条 Codex 提示词之后,Astra 活干不了也不说的比例能压回 8.04%,Sol 压回 8.88%。但在 Broken Search Tool 上,Astra 带了提示词也有 8.50%,还是比上一代的 7.58% 略差一点。系统卡里明确写着,这条提示词不会默认加进直接调 API 的请求里。只打提示词补丁而不重新训练模型,我的推测是重训太烧算力。至于 API 为什么不默认加,分析下来是因为提示词归 Codex 产品管,API 用户都有自己的系统提示词,官方默认往里加词会改变接口原本的行为 。
今年9月3日、4日和7日,因为 Astra 延期发布,OpenAI 给过三次额度重置。11月11日到13日,Codex 负责人 Tibo也因为 Dots 更新激活过一次存量重置。到了11月18日 GPT-6.2 正式上线,官方帮助中心和 Tibo 的推文里都没有宣布新的发布重置,帮助中心还专门写明,之前的每日重置是为了补偿整体延期,发布后的个人访问问题不享受额外重置。
官方博客这次的说法是,新模型用更少的输出 token 完成高要求任务,「这样你就能在使用额度内干完更多事」。Tibo 发推也强调模型极其高效,你的使用额度能比以前撑得更久。隔壁 Anthropic 发 Claude Fable 5.2 时先给了一次专项重置,随后因为修复了几个多吃使用额度的小问题,给 Pro 和 Max 用户、以及 Ultra 与 Team 订户发了一次全量免费重置,能用到12月11日。说实话,给全量用户重置使用额度,就等于直接往外送算力。
要我选的话,现在写代码和跑复杂长任务,首选依然是 Claude Fable 5.2。它排在 AA 综合榜第一,发布前的开发者采用率是 39% 对 16%,而 GPT-6.2 在第三方编程榜上原地踏步,还有活干不了也不说的毛病。GPT-6.2 更适合那些对成本敏感、做 3D 视觉或科学计算、或者照着截图还原排版这类省钱的活。
现在就要上手用 GPT-6.2 的话,有两个具体做法:
复制本文链接
本内容只为提供市场信息,不构成投资建议。该文章为中币网所有,未经允许不得转载。
12分钟前 链上吃瓜员
15分钟前 辣辣辣条
31分钟前 链上吃瓜员
近期热门
更多
2026-11-19 链上吃瓜员
2026-11-18 链上吃瓜员
2026-11-18 链上吃瓜员
2026-11-18 链上吃瓜员
2026-11-16 链上吃瓜员
2026-11-14 链上吃瓜员
2026-11-14 链上吃瓜员
2026-11-14 链上吃瓜员
2026-11-14 链上吃瓜员
2026-11-12 链上吃瓜员
精选专题
更多热门标签
更多